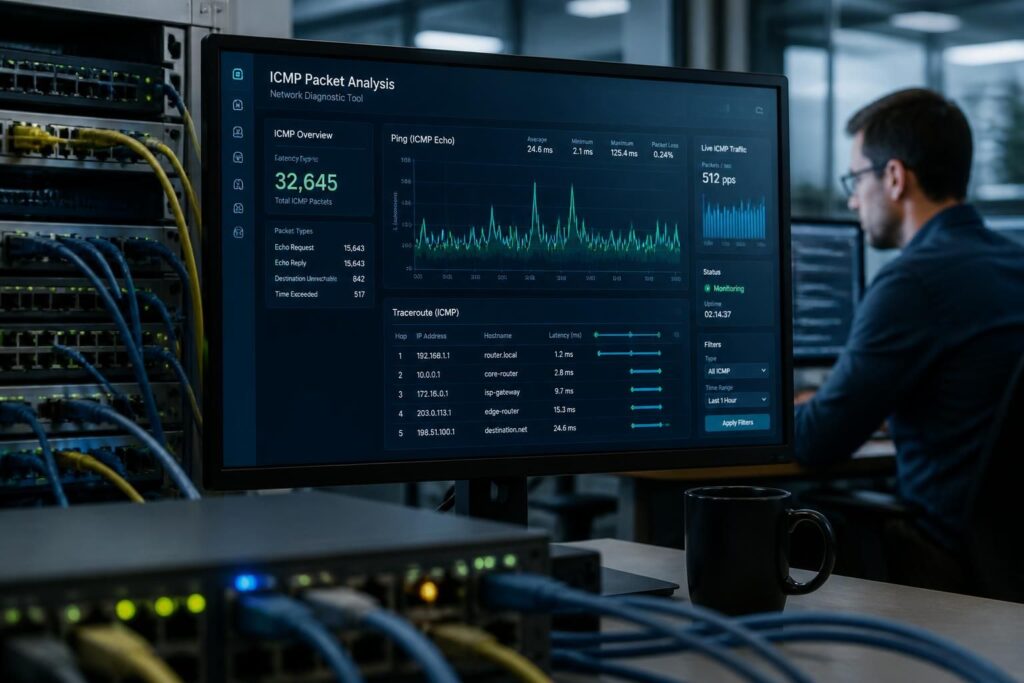
Invisible quand tout va bien, ICMP devient indispensable dès qu’un réseau commence à faiblir. C’est lui qui donne des indices quand un serveur ne répond plus, quand un trajet se casse en route ou quand la latence grimpe sans prévenir. Dans la pratique, ce petit protocole réseau évite de perdre du temps à deviner : il éclaire la connectivité réseau, signale les erreurs et permet de remonter la piste jusqu’à la source du problème.
L’article en bref
ICMP n’est pas là pour transporter vos données, mais pour dire ce qui se passe quand le réseau hésite. Ping, traceroute et messages d’erreur deviennent alors des alliés concrets pour accélérer l’analyse réseau.
- Rôle discret mais décisif : ICMP remonte les incidents sans transporter de contenu utilisateur
- Outils de terrain : ping mesure la joignabilité et la latence
- Lecture du chemin : traceroute révèle les sauts et les blocages
- Réflexe de sécurité : filtrer ICMP intelligemment, jamais aveuglément
Bien configuré, ICMP reste un raccourci précieux entre panne perçue et diagnostic réel.
Sur le papier, ICMP paraît presque austère. Dans un réseau informatique réel, c’est pourtant l’un des outils les plus utiles pour comprendre pourquoi une machine reste muette, pourquoi une route disparaît ou pourquoi un service semble “lent” alors que le vrai problème se trouve ailleurs. Personne ne vous dit ça quand on parle de protocoles, mais la plupart des incidents commencent par une question simple : où le flux s’est-il arrêté ? ICMP apporte une réponse rapide, souvent en quelques millisecondes, là où une approche purement applicative ferait perdre un temps fou.
Prenons un cas concret : une équipe en production voit un serveur web devenir capricieux à 9 h du matin. Le site charge parfois, parfois pas. Avant de blâmer le moteur, la base de données ou le cloud, un ping vers l’hôte montre déjà si la machine répond. Un traceroute indique ensuite si la rupture se produit chez le premier routeur, chez le FAI ou plus loin. Cette logique est simple, mais elle change tout : le diagnostic réseau cesse d’être une loterie et devient une enquête structurée.
ICMP, la couche de signalisation qui accompagne IP
ICMP signifie Internet Control Message Protocol. Son travail n’est pas d’acheminer des fichiers, des pages web ou des e-mails, mais de transmettre des messages de contrôle et de gestion des erreurs autour d’IP. Autrement dit, il sert de système de retour d’information quand un paquet n’a pas pu aller au bout de son trajet. Dans une architecture réseau, cette fonction est essentielle, parce qu’IP essaye de livrer les données sans garantir, à lui seul, le pourquoi du succès ou de l’échec.
Le point important, c’est qu’ICMP ne joue pas le même rôle que TCP ou UDP. Il n’établit pas de session, ne gère pas un échange applicatif et ne promet aucune fiabilité de transport. Il se comporte plutôt comme un panneau de signalisation : “route fermée”, “chemin trop long”, “destination inaccessible”. Dans un environnement indie comme dans une grosse infra AAA, la logique est identique : sans visibilité, on avance à l’aveugle. Ici, ICMP donne justement cette visibilité minimale mais décisive.
Il faut aussi distinguer ICMP d’ICMPv6. Le premier accompagne surtout IPv4, tandis que le second remplit le même rôle dans l’univers IPv6. Le langage change un peu, la mission reste la même : fournir un mécanisme de retour quand la couche IP ne peut pas expliquer seule ce qui s’est passé. C’est une différence subtile, mais elle compte dans les réseaux modernes qui mélangent encore plusieurs générations d’adressage.
Comment un paquet ICMP se présente
Un message ICMP voyage lui-même dans un paquet IP. C’est précisément ce qui lui permet de circuler partout où IP passe déjà. Pour être compris par les équipements, il porte un numéro de protocole spécifique dans l’en-tête IP, ainsi qu’un type et un code qui détaillent la nature du message. Cette structure évite les interprétations floues et rend l’information exploitable par les outils réseau.
Le type donne la grande famille du message, par exemple une requête d’écho ou une destination inaccessible. Le code affine le diagnostic, comme un sous-diagnostic d’atelier sur une panne mécanique. Quand un routeur dit qu’une destination est injoignable, il ne parle pas dans le vide : il précise pourquoi, ou au moins dans quelle direction chercher. C’est cette granularité qui rend l’analyse réseau efficace.
| Message ICMP | Ce qu’il indique | Usage courant |
|---|---|---|
| Echo Request / Echo Reply | Teste la joignabilité d’un hôte | ping |
| Destination Unreachable | Le paquet ne peut pas être livré | Routage absent, port fermé, filtrage |
| Time Exceeded | La durée de vie du paquet est épuisée | traceroute, détection de boucle |
| Redirect | Une meilleure route existe | Cas plus ancien, usage encadré |
Ce tableau résume l’essentiel, mais la vraie valeur d’ICMP se voit quand les symptômes s’accumulent. Une erreur de route, un pare-feu trop strict ou une passerelle mal configurée ne produisent pas le même message. C’est justement là que le protocole réseau fait gagner du temps : il transforme un doute général en piste technique exploitable.
Ping et traceroute : les deux réflexes qui sauvent du temps
Ping est l’usage le plus connu d’ICMP, et ce n’est pas un hasard. La commande envoie un Echo Request, attend un Echo Reply et mesure le temps aller-retour, aussi appelé RTT. Si l’hôte répond vite et régulièrement, la communication est saine. Si les réponses tardent, disparaissent ou varient beaucoup, il y a déjà matière à creuser. Votre problème n’est pas le moteur à ce stade ; c’est souvent la route, la charge ou le filtrage.
Traceroute, lui, raconte une autre histoire. Il exploite le TTL, le “temps de vie” d’un paquet IP, en le réduisant à chaque routeur traversé. Quand la valeur tombe à zéro, un équipement renvoie un message ICMP Time Exceeded. En répétant l’opération avec des TTL croissants, l’outil reconstitue le chemin complet. Ce mécanisme est simple, presque élégant, et redoutablement utile quand un trajet casse au milieu de nulle part.
Dans les équipes techniques, ces deux commandes sont le premier filtre avant d’ouvrir un ticket, d’appeler un fournisseur ou de toucher à la configuration. C’est aussi pour cela que de nombreux outils de supervision les utilisent en boucle, sur des serveurs, des routeurs, des imprimantes réseau ou des passerelles critiques. Le silence d’un hôte n’est jamais une preuve absolue de panne, mais c’est un signal trop important pour être ignoré.
Pour les services en ligne, la réactivité reste un critère brutal. Une latence de quelques millisecondes peut sembler insignifiante, jusqu’au moment où elle s’ajoute à des dizaines d’autres micro-retards. C’est le même genre de détail qui change l’expérience d’un jeu multijoueur ou d’un outil SaaS. Le diagnostic commence donc souvent par le plus simple, pas par le plus spectaculaire.
Pour aller plus loin sur ce point, un détour par l’importance du ping dans les jeux en ligne montre bien pourquoi la mesure de latence n’est pas un détail théorique. La logique est la même côté réseau : comprendre le délai, c’est déjà comprendre une partie du problème.
Ce que ces outils révèlent vraiment
Ping répond à une question binaire : la machine répond-elle ou non ? Mais la lecture ne s’arrête pas là. Un RTT instable peut signaler une congestion, un chemin plus long que prévu ou un équipement qui sature à certains moments de la journée. En production, ces indices sont plus utiles qu’un simple “ça marche” ou “ça ne marche pas”.
Traceroute, lui, permet de localiser le point de rupture. Un routeur qui coupe les réponses, une passerelle intermédiaire qui ne relaie plus rien, un filtrage en bordure de réseau : chacun laisse une trace différente. C’est exactement ce qui rend ICMP si précieux dans un diagnostic réseau sérieux. Il ne donne pas une réponse magique, mais il élimine vite les mauvaises hypothèses.
- Ping vérifie si un hôte est joignable et mesure la latence.
- Traceroute identifie les routeurs traversés jusqu’à la destination.
- Destination Unreachable signale qu’un paquet ne peut pas être livré.
- Time Exceeded indique qu’un paquet a dépassé sa durée de vie réseau.
Ces quatre lectures suffisent déjà à orienter une bonne partie des investigations. Le piège, c’est de croire que l’absence de réponse signifie toujours une panne. Parfois, c’est juste un équipement qui refuse volontairement les paquets ICMP. D’où l’intérêt de croiser les indices plutôt que de s’en remettre à un seul signal.
Les erreurs ICMP qui parlent le mieux d’un incident
Les messages ICMP les plus utiles en exploitation sont souvent ceux qu’on remarque le moins. Destination Unreachable est l’un des plus parlants : il peut signaler qu’un réseau, un hôte, un protocole ou un port est inaccessible. Dans certains cas, il indique aussi qu’une fragmentation serait nécessaire mais interdite. Ce détail paraît technique, mais il évite de confondre un problème de taille de paquet avec une panne de service.
Time Exceeded est tout aussi important. Il sert à tracer les chemins, mais aussi à détecter des boucles de routage, ces scénarios où les paquets tournent en rond sans atteindre leur cible. C’est typiquement le genre de bug qui dégrade la connectivité réseau sans déclencher immédiatement une alerte spectaculaire. Un réseau peut sembler “vivant” tout en étant inutilisable sur certains segments.
Historiquement, ICMP a aussi porté des messages de type Redirect, censés informer d’une meilleure route. Aujourd’hui, leur usage est plus encadré, car ils peuvent devenir une faiblesse s’ils sont acceptés sans contrôle. Les architectures modernes privilégient des politiques de routage plus propres et des règles de sécurité mieux bornées. Là encore, la prudence paie.
Pourquoi bloquer ICMP n’est pas toujours une bonne idée
ICMP a mauvaise réputation parce qu’il peut servir à cartographier un réseau, identifier des machines actives ou alimenter certaines attaques par déni de service. Des paquets ICMP envoyés en masse peuvent épuiser des ressources, surtout sur des cibles mal protégées. Résultat : beaucoup d’équipes coupent tout par défaut, par réflexe.
Le problème, c’est qu’un blocage total casse aussi des mécanismes utiles. Certains messages servent à ajuster la taille des paquets, d’autres aident à comprendre qu’un chemin existe mais pose un problème précis. La bonne stratégie consiste donc à filtrer intelligemment, pas à supprimer toute visibilité. Dans un réseau bien géré, on limite les réponses depuis Internet tout en gardant des échanges utiles en interne ou depuis des sondes de supervision identifiées.
Dans la pratique, cette approche évite de sacrifier le diagnostic réseau sur l’autel d’une sécurité trop brutale. La sécurité sérieuse ne coupe pas tout ; elle distingue ce qui doit être exposé de ce qui doit rester silencieux. Et c’est souvent là que les administrateurs gagnent en efficacité.
ICMP dans l’écosystème réseau moderne
ICMP ne remplace ni HTTP, ni SMTP, ni les autres protocoles applicatifs. Il travaille en arrière-plan, comme un mécanisme de contrôle qui aide les services à rester observables. Quand un serveur de messagerie répond au ping mais refuse les mails, le diagnostic se déplace vers le service lui-même. Quand même le ping échoue, l’enquête commence plus bas, sur la couche réseau.
Cette séparation est utile, parce qu’elle évite de mélanger problème applicatif et problème d’infrastructure. Un site web peut être inaccessible à cause d’un pare-feu, d’un DNS bancal ou d’un service arrêté ; ICMP ne dira pas tout, mais il écarte déjà certaines pistes. C’est une information simple, et pourtant elle change la manière de prioriser les actions.
Les grands réseaux de 2026 s’appuient encore sur ce signal minimal. Les dashboards de supervision, les alertes automatisées et les sondes de disponibilité continuent d’utiliser ICMP parce qu’il est léger, rapide et universel. Ce n’est pas glamour. C’est précisément pour cela qu’il reste indispensable.
Une méthode de terrain qui reste valable
Une bonne routine de diagnostic commence souvent par une séquence courte : ping local, ping passerelle, ping cible, puis traceroute si le chemin semble cassé. Cette progression évite de partir dans tous les sens. Elle permet aussi de distinguer un problème interne d’un incident externe. Le scope est l’ennemi, même en réseau.
Imaginons une PME avec un VPN instable. Les utilisateurs accusent le cloud, mais les tests montrent que la passerelle locale répond, puis qu’un saut intermédiaire disparaît régulièrement. Le problème n’est plus “Internet” en général : il est situé, mesurable, donc corrigeable. C’est exactement le genre de situation où ICMP fait gagner des heures.
Pour approfondir la logique de mesure côté navigation et route, cette ressource sur le rôle du ping dans les performances en ligne complète bien la lecture. Même quand les contextes changent, la mécanique reste identique : comprendre le trajet, c’est déjà maîtriser l’incident.
Le protocole ICMP n’a rien de spectaculaire, et c’est pourtant sa force. Il apporte juste assez de visibilité pour transformer une panne confuse en problème lisible, ce qui est souvent la différence entre subir un incident et le résoudre vite. Un bon jeu ne naît pas d’une idée brillante. Il naît d’une exécution maîtrisée.
À quoi sert ICMP dans un réseau IP ?
ICMP sert à transmettre des messages de contrôle et d’erreur entre machines. Il aide à signaler une destination injoignable, un chemin défaillant ou un paquet arrivé trop tard.
Ping utilise-t-il vraiment ICMP ?
Oui. Ping envoie des messages Echo Request et attend des Echo Reply pour vérifier si une machine répond et pour mesurer la latence aller-retour.
Pourquoi traceroute affiche-t-il parfois des étoiles ?
Les étoiles apparaissent quand un routeur ne répond pas aux sollicitations ICMP ou filtre ces messages. Cela ne veut pas toujours dire que le chemin est coupé, mais il manque une partie de la visibilité.
Faut-il bloquer ICMP sur un pare-feu ?
Pas totalement. Mieux vaut filtrer les types de messages inutiles et limiter les réponses publiques, tout en conservant les flux nécessaires au diagnostic réseau et à la supervision.
Quelle différence entre ICMP et ICMPv6 ?
ICMP accompagne surtout IPv4, tandis qu’ICMPv6 remplit le même rôle dans IPv6. Les deux servent à la gestion des erreurs et au contrôle du réseau, avec des spécificités adaptées à chaque version d’IP.


